学习链接:李宏毅生成式人工智能导论2024
该视频引用的论文来源:arxiv
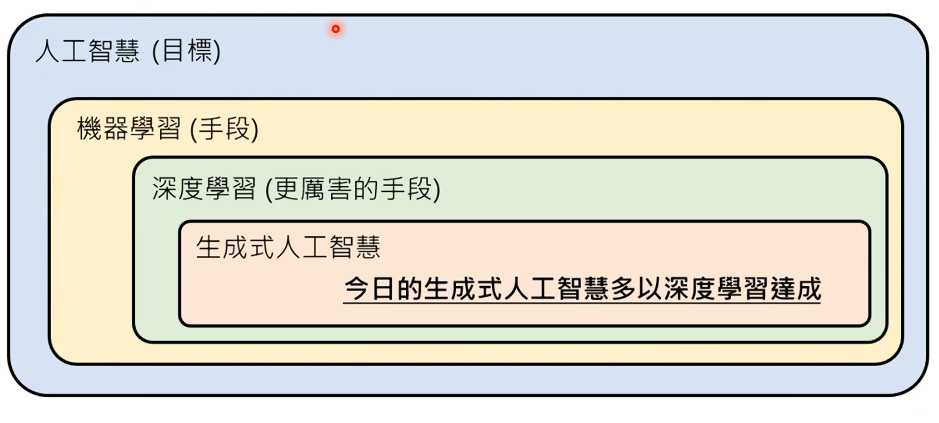
生成式人工智慧(Generative AI)
基本概念
- 生成式人工智慧是人工智慧众多可能目标之一,是机器产生复杂有结构的物件
- 文章 - 由文字所构成
- 影像 - 由像素所构成
- 语音 - 由取样点所构成
- 机器学习(Machine Learning)是生成式人工智慧的基础 — 机器自动从资料中找一个函数,即从函数中自动找参数并计算出最佳的参数值(学会文字接龙的过程)
- 模型(Model): 有大量参数的函数
- 训练(Training): 从大量参数中找最佳的参数值的过程
- 训练资料(Training Data): 训练模型的资料,带有如何找出正确参数的条件
- 推论、测试(Inference、Testing): 找出参数后,用模型资料生成新的资料的过程
- 类神经网络(Neural Network): 表示大量参数的函数,通过多个层的神经元来表示复杂的函数
- 深度学习(Deep Learning):把类神经网络的大量参数解出来的过程,是一种机器学习技术
神经网络(Neural Network) — 感知机(Perceptron)
- 神经网络: 由多个神经元(Neuron)组成,每个神经元都有自己的权重(Weight)和偏置(Bias)
- 神经元: 一个简单的函数,输入一个或多个信号,输出一个信号
- 神经元的信号: 一个或多个神经元的输出, 也可以是外部输入
- 神经元的输出: 一个或多个神经元的输入, 也可以是外部输出
- 感知机(单神经元结构):信息在神经元中的处理过程可以通过一个有多个输入和一个输出的计算机程序来进行模拟。即一个根据加权输入的总和是否满足阈值来做出输出0或1的简易的简易程序。
“亚符号”派
- 某种意义上说,神经刺激可以被认为是亚符号化,然后以它们为基础,大脑创造出了符号。类比于大脑的亚符号化的神经网络,感知机以及更复杂的模拟神经元网络,也被称为“亚符号”派。
- 这一派的人认为,若要实现生成式人工智慧,需要先实现“亚符号”派的神经网络。
- 由此引出层级神经网络,卷积神经网络,循环神经网络,深度信念神经网络等模型
图片识别
- 给感知机设定视觉任务
- 然后感知机在样本上进行的奖励和惩罚训练
- 通过学习获得为一个给定任务的识别能力的正确权重和阈值
- 语言模型: 拆解成一连串的文字接龙和分类问题, 从有限的答案中找到
- 生成策略(Generation Strategy):
- 自回归生成(Autoregressive Generation): 把复杂的物件拆解成较小的单位,依照某种固定的顺序依序生成
大语言模型(Large Language Model 即 LLM)
- 当前所有AI技术的核心引擎
- 基于Transformer 的架构训练而成
- 本质和底层运作机制: 一个文字接龙游戏
Token:
- 大模型的本质是数学函数,只认数字
- 人类 与 模型 之间的沟通单位, 负责编码(文字->数字)和解码(数字->文字)
- 无论是一个英文单词还是一个中文字符, 都可以拆成多个Token
- 注:
- 一个Token ≈ 0.75个英文单词
- 一个Token ≈ 1.5~2个汉字
形成的过程:
- 预训练(Pre-training): 用未标记的资料训练模型, 使模型能够学习到文字的结构和关系
- 最佳化:通过训练资料找参数的过程(设置初始参数和超参数)
- 督导式学习
- 基石模型(Foundation Model): 用预训练的模型作为基础
- 微调(Fine-tuning): 用标记的资料训练模型, 使模型能够根据标记的资料来生成新的资料
- 增强式学习(Reinforcement Learning)
- 用奖励和惩罚来训练模型, 使模型能够根据环境的反馈来学习最佳的行为
不训练模型的情况下,提高模型的生成质量的方式
- 大模型推理妙招 – 用增强式学习,提高模型对某一方面的生成质量(不是所有模型都能用)
- Chain of Thought(CoT): 模型思考,Let‘s think step by step.
- 请模型解释生成的内容
- 对模型情绪勒索
- 用AI来找神奇咒语
- 提供范例,让模型学习 - 越强模型越能看懂范例
- 拆解任务,让模型分步骤完成任务
- 让模型反省 - 反省的过程没有任何模型被训练,函式是固定的,所以答案不会变
- 组合拳(XXX of Thought):把一些复杂的任务拆解成多个小任务然后组合让模型完成
- 使用工具(Tools): 让模型能够调用外部工具来完成任务
- 上网搜索
- 写程式
- 文字生图AI(DALL-E等)
- Toolformer:学会使用多种不同工具的AI
- 大模型推理妙招 — 投机采样(Speculative Decoding):
- 大模型推理加速,在不损失生成效果的前提下,获得3x的加速比
- 方法: Non-autoregressive Model or 搜索引擎 or 多个预言家
机器模型的可解释性(Explainable ML)
- 给每一个参数加权重,找到最重要的那一项
攻击语言模型的方式
| Jailbreaking | Prompt Injection | |
|---|---|---|
| 攻击对象 | 语言模型本身 | 以语言模型打造的应用(如:AI助教) |
| 攻击结果 | 说出作为一个语言模型不该讲的话 | 让语言模型怠忽职守,在不恰当的时机做不恰当的事 |
| 对应人类行为 | 杀人放火 | 上课时突然唱歌 |
生成影像的生成式AI
- Talking Head : 给一段语言 和一张图片, 生成会说话的影响
- 影片是有一张张图片所构成,即这里图片叫帧(Frame),fps指每秒有多少张图片
- 图片 -> 经过Encoder 把图片切割多个patch压缩 -> 用Decoder解码 -> 生成影像
- 影片 -> 经过Encoder 把时间等压缩 -> 用Decoder解码排成一排 -> 生成影像
- 评价影像生成的好坏:CLIP 模型
Transformer 模型的原理
- 把文字变成Token
- 语言模型是以Token作为单位来对文字进行处理
- https://platform.openai.com/tokenizer 可以知道一段文字有多少Token
- 每个Token用向量表示
- Embedding: 把每个Token变成向量来表示的过程,每个向量中包含了Token的含义
- Positional Encoding: 把每个Token的位置信息加入对应Token的向量中
- 考虑上下文
- 找出相关的Token,计算每个向量的相关性(Attention Weight)
- 集合相关的资讯,每个向量*相关性然后相加就得到这个位置的相关性(加权和), 这个相关性越高,下一个接龙的可能性越高
- 多个Attention 组合成 一个Transformer block
- 然后会有多个Transformer block, 直至最后一次输出结果
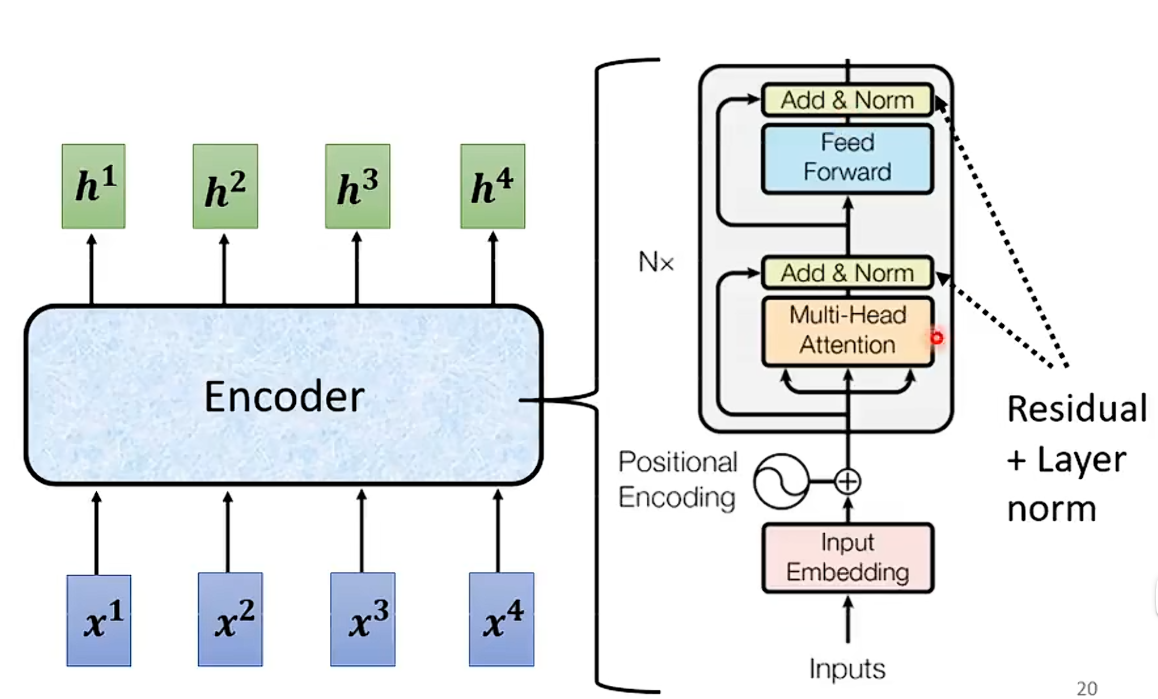
Seq2seq Model
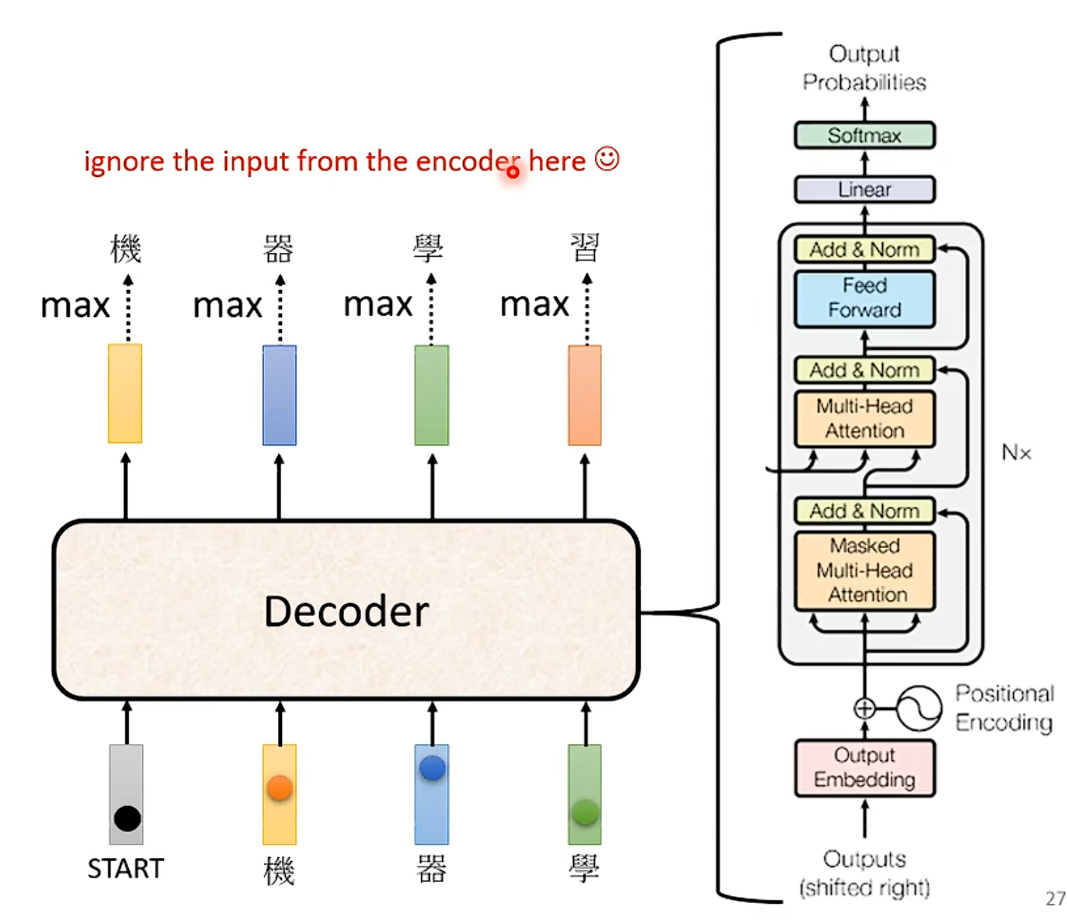
- 基于Transformer的Seq2seq model 来源于 attention is all you need
- seq2seq model 的 组成部分:
- Encoder:把输入的Token变成一排向量,然后用Transformer block来处理,然后输出另一排向量
- Decoder: 把输出的Token变成一排向量, 然后用Transformer block来处理
- 先进行 Masked Multi-Head Attention处理 之后步骤与Encoder相同
- 然后经过softmax归一化, 把输出的Token变成概率分布
- 应用场景
- Seq2seq for Chatbot
- input -> seq2seq -> response
- Seq2seq for Multi-label Classification
- 同一个东西可以属于多个类
- Seq2seq for Object Detection
- 把图片里的物件框出来
- Seq2seq for Chatbot
Autoregressive VS Non-autoregressive
在机器学习和统计学中,处理序列数据时(如时间序列分析、自然语言处理等)两种常见的模型
自回归模型(Autoregressive Model):
- 定义:一种基于自身历史数据进行预测的线性或非线性统计模型。它假设当前输出仅依赖于其前面的若干输出值。
- 基本原理: 通过拟合一个函数,该函数将历史数据作为输入并预测下一个时间点的输出。
非自回归模型(Non-autoregressive Model):
- 定义:不依赖于自身的历史数据来进行预测,而是可能利用其它类型的特征或上下文信息来直接生成输出。
- 基本原理:并行生成所有输出,而不是像自回归模型那样逐步生成每个输出。
Autoregressive(AR) Non-autoregressive(NAT) 特性 顺序生成,每次只能生成一个 并行生成 速度 慢 快 性能 更好(连贯性佳) 一致性和连贯性不稳定 应用 文字、语音 影像
AT vs NAT
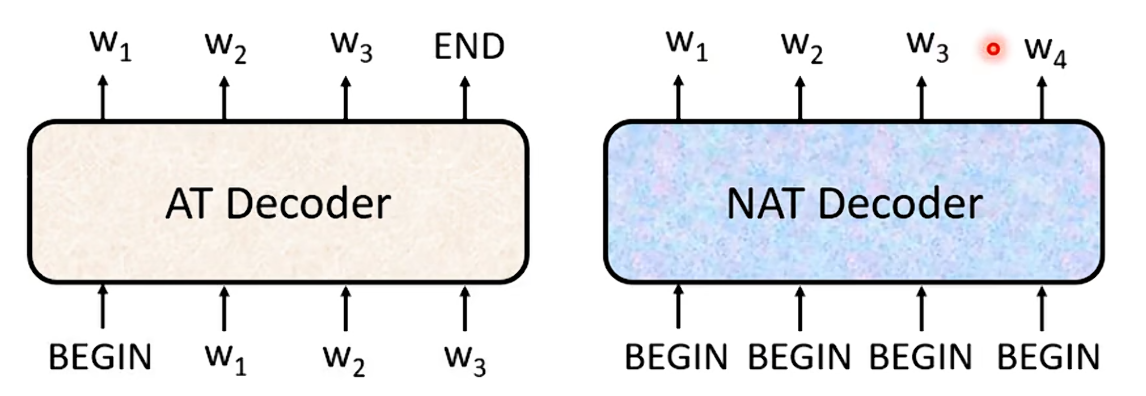
- Autoregressive Transformer(AT):
- 一次只生成一个Token, 从左到右生成
- Non-Autoregressive Transformer(NAT):
- 可以控制输出长度
- 输出一个非常长的序列,忽略END之后的标记
Tool 与 MCP
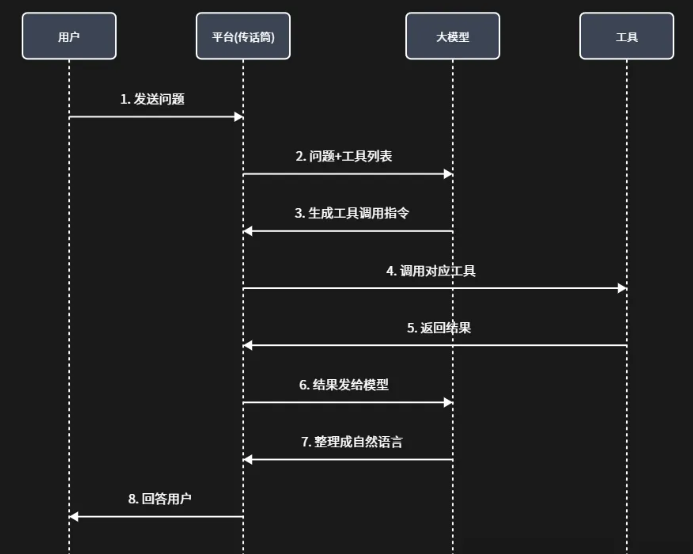
- Tool:
- 本质是一个函数: 输入参数 -> 执行操作 -> 返回结果
- 流程:
- MCP(Model Context Protocol): 模型上下文协议
- 本质: 统一的工具接入标准
- 作用: 工具开发者只需按MCP规范来实现工具,即可在所有支持MCP的平台中使用
Agent(智能体) 与 Agent Skill
- Agent: 能自主规划、调用工具、持续工作直至任务完成的系统
- 工作流程: 调用对应工具,综合所有信息并返回结果
- Agent Skill: 提前写给Agent看的说明文档(Markdown 格式)
- 结构:
- 元数据层: 名称 + 描述
- 指令层: 目标、执行步骤、判断规则、输出格式、示例
- 创建步骤
- 在.cloudskills目录新建一个文件, 文件名就是Agent Skill的名称
- 在对应Agent Skill 的文件中创建SKILL.md文件(必须大写)
- 在SKILL.md文件中写入完整指令内容
- Agent在匹配时会自动加载执行
- 结构:
Prompt Engineering、Context Engineering、Harness Engineering
- 从指令到系统,核心概念图
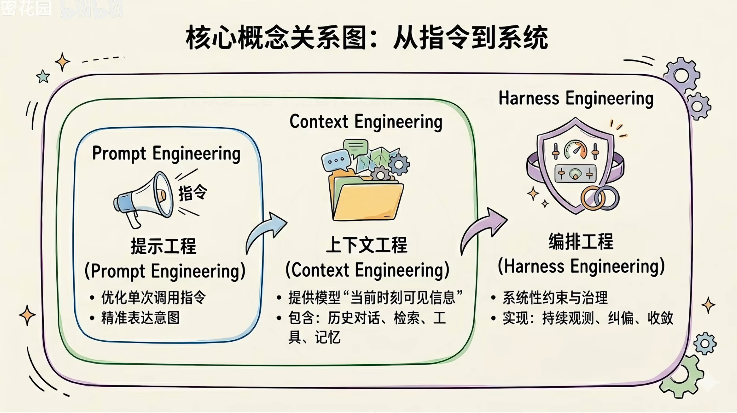
提示词工程(Prompt Engineering)
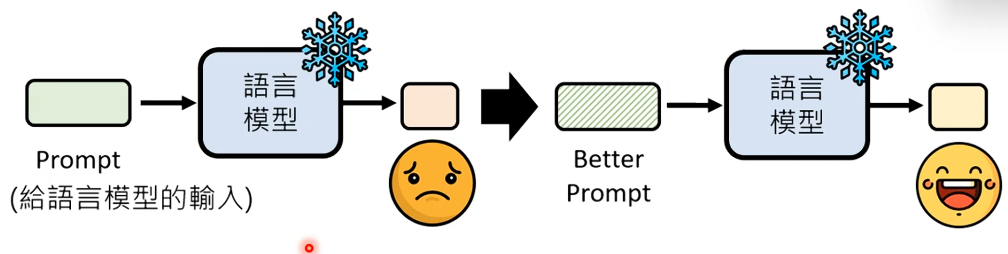
- 用文字来描述模型要生成的资料, 使模型能够根据描述来生成资料
- Prompt: 提示词,给大模型的指令
- User Prompt: 用户输入的问题
- System Prompt: 系统指令, 开发者配置的人设和规则
- Tool Prompt: 工具调用的指令
上下文工程(Context Engineering)
- Context: 模型每次处理任务时接受的信息总和
- 用户当前问题
- 对话历史
- 正在输出的Token
- 工具列表
- system prompt等
- Context Window:Context 能容纳的最大 Token 数量
- 解决模型内存不足的问题: RAG(Retrieval-Augmented Generation)技术
- 越长越能读大段资料,但会更慢更贵
- 常用: 32k - 128k
- 超长: 200k-100万(慎用,很慢)
指令束工程(Harness Engineering)
- Prompt的进化,AI的完整工作手册
- 完整的指令体系:
- 身份定义、行为边界、工具使用规则、输出格式、质量标准
大模型术语与选型
学习链接:大模型术语与选型-超简版
参数量: 数字越大,能学会的东西越多,但更费钱更慢
- 参数量:神经网络的输入权重和输出阈值的总和
- 超小/边缘模型: 0.5B - 3B (手机、IoT设备[8])
- 小: 7B - 8B(入门、高性价比)
- 中: 14B - 32B(均衡、常用)
- 大: 70B - 100B(高质量)
- 超大: 100B+(顶级能力)
- MoE[9]:总参数大但激活少(高性价比) — DeepSeek-V3: top-8(256专家中选8个)
Temperature(温度)
- 控制模型生成的随机性
- 温度越高,模型生成的随机性越高
- 温度越低,模型生成的随机性越低,越确定
- 常用值: 0.5 - 1.0
泛化:
- 会触类旁通,也能做的像样。 — 只学过中文数学题,也能做英文数学题
推理模型 VS 普通模型:
- 推理模型: 会写草稿、分步骤想,解难题更稳
- 普通模型: 直接给答案,简单题快,复杂题不稳
VL模型(Visual-Language Model):看图说话
- 能看图、视频又能理解文字,比如“读图、问图、按文字生成图
端侧模型
- 端侧模型:用于在边缘设备(如手机、智能设备等)上本地运行的模型,不需要联网就能运行的AI模型。
- 云端 VS 端侧
- 云端:数据发到服务器 -> 服务器算 -> 结果返回(需要网络,有延迟,隐私风险)
- 端侧:数据不出设备 -> 本地算 -> 本地出结果(离线可用,快,隐私安全)
- 端侧的优点:
- 隐私安全: 数据不上传,敏感信息不泄露 — 医疗诊断、个人日记、企业文档
- 离线可用: 无网络也能用 — 飞行模式
- 低延迟: 不用等网络往返,毫秒级响应 — 实时翻译,语音助手、游戏助手
- 省成本: 不用付云端API费用 — 高频调用场景
- 个性化: 可以针对用户习惯微调 — 个人助理、学习伴侣
- 端侧模型
- 谷歌发布的开源模型 Gemma 系列
- 阿里的 Qwen2.5-0.5B/1.5B/3B
- 微软的 Phi-3-mini 小而精,推理强
- 技术要求
- 模型压缩:量化[10](INT4/8)、剪枝、蒸馏,把模型瘦身
- 推理优化:专用芯片(NPU、神经引擎)、算子融合、内存优化
- 设备要求:
- 手机: 需要4GB+RAM,支持NPU更好
- 电脑: 8GB+RAM,有独显更好
- IoT:需要专门优化的超小模型(<500MB)
应用
- Whisper: 语音识别模型
注
[1]Self-Attention:发生在单个句子内,它的Query和Key都是同一个向量, 只是Attention Weight不同(即序列内部做Attention), 所以输出的向量和输入向量是一致的;可以捕获全局信息,无论词的位置在哪,词之间的距离都是1。
[2]Multi-Head Attention: 用多个头来处理Attention, 每个头都有自己的Query、Key、Value, 最后把所有头的输出拼接起来,再映射到原始的向量维度。
[3]Residual Connection:把Self-Attention处理得到的向量 + 输入向量 = 新的向量的过程
[4]Layer normalization: 计算mean(m)和standard deviation(std),把Residual Connection返回的值-m/std的值输出,每个Layer的输入和输出的维度是一致的。
[5]Feed-forward network: 把Layer normalization输出的值, 用一个全连接层来处理, 输出一个新的向量。
[6]Positional Encoding: 把每个Token的位置信息加入对应Token的向量中
[7]Embedding(嵌入): 把每个Token变成向量来表示的过程,每个向量中包含了Token的含义
[8]IoT设备:物联网设备,指连接到互联网的设备,如传感器、智能设备等。
[9]MoE:Mixture-of-Experts混合专家模型。每个 MoE 层包含 1 个共享专家和 256 个路由专家,每个 Token 选择 8 个路由专家,最多路由至 4 个节点。每次只叫少数专家上场,容量大,工程更复杂。激活数就是上传的专家数(top-n)。数字越大,可能更准,但更费算力。
[10]量化:使用小整数和矢量化指令集对更小类型进行硬件加速。量化模型的最简单方法:首先找出权重的最大值和最小值,然后将数值范围划分为整数类型中可用的桶数,8位为256桶,4位为16桶。